RAG: anna mallille lähde, josta etsiä vastaus
Hakua hyödyntävä generointi (retrieval-augmented generation, RAG) hakee olennaista aineistoa ja antaa sen kielimallille vastauksen kontekstiksi. Tänään päivitetty dokumentti voi palvella jo seuraavaa pyyntöä ilman mallin uudelleenkoulutusta.
Tavallisessa toteutuksessa dokumentit jaetaan tekstikatkelmiin, joista jokaiselle tallennetaan upotusvektori (embedding). Myös kysely muunnetaan vektoriksi. Samankaltaisuushaku löytää ehdokkaat, joita erillinen järjestämismalli (reranker) voi vielä arvioida ennen valittujen tekstien liittämistä kehotteeseen. Myös avainsanahaku tai hakutapojen yhdistelmä toimii.
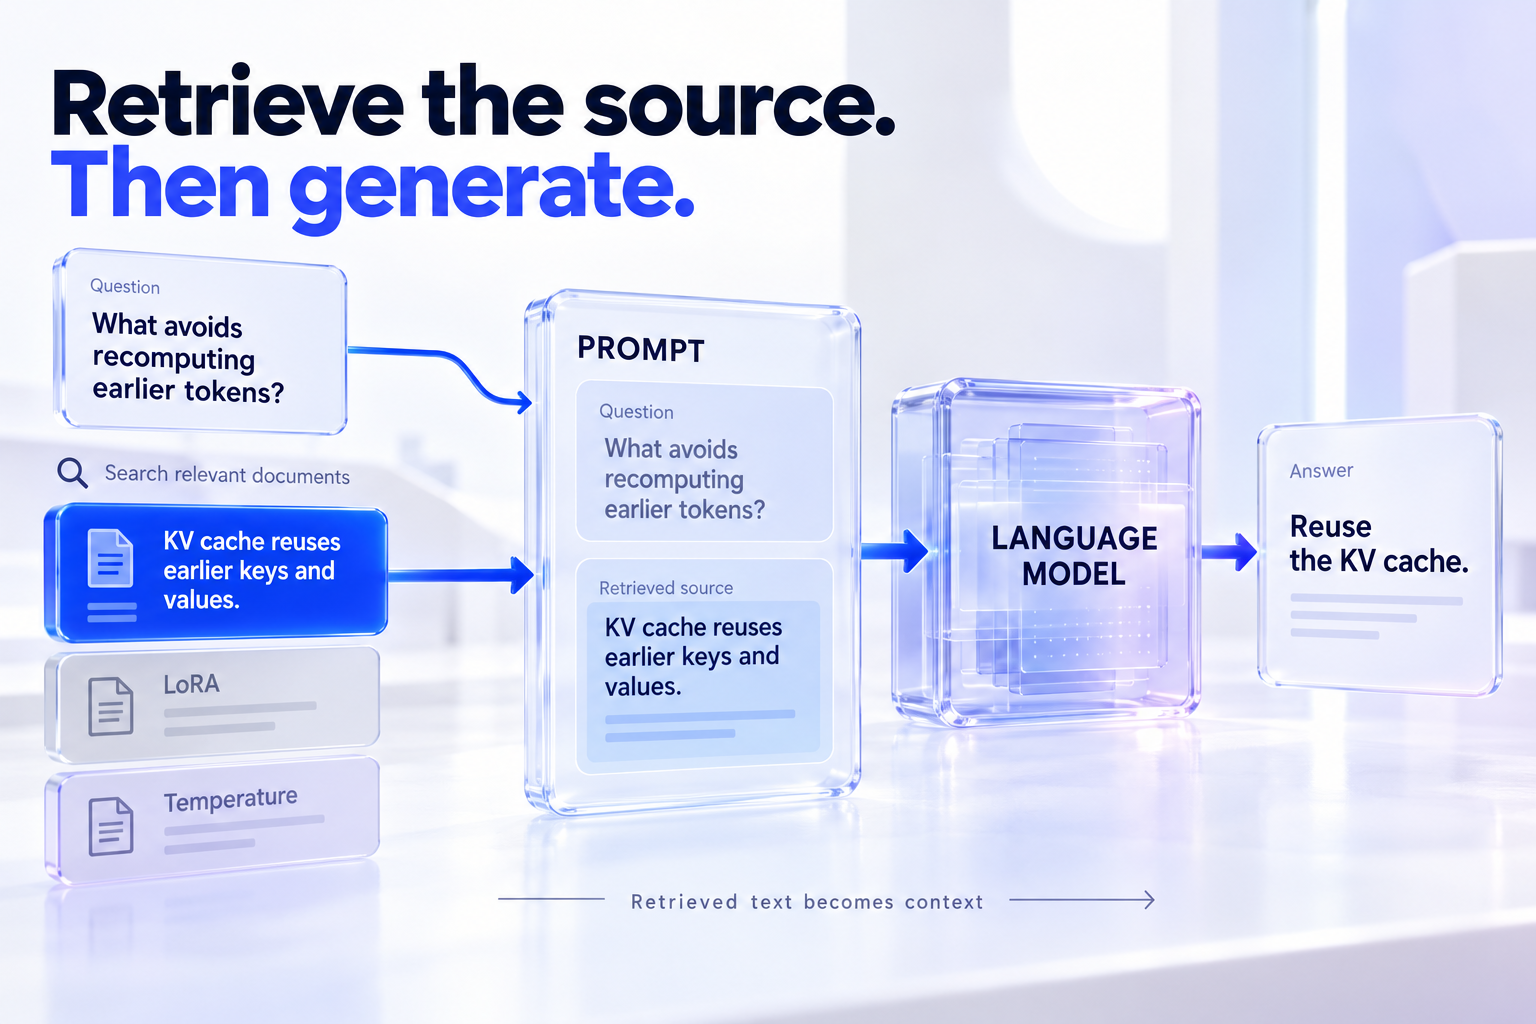
Hausta tekstin generointiin
Tämä esimerkki muodostaa kolmen katkelman upotukset, hakee yhden ja antaa sen tekstin pienelle ohjeita seuraavalle kielimallille. Normalisoitujen vektorien pistetulo vastaa kosinisamankaltaisuutta. Kokeiluun tarvitaan sentence-transformers, transformers ja torch; ensimmäinen ajo lataa kaksi mallia.
import numpy as np
from sentence_transformers import SentenceTransformer
from transformers import pipeline

documents = [
    "KV cache reuses keys and values from earlier tokens.",
    "LoRA trains low-rank updates while base weights stay frozen.",
    "Temperature changes how token probabilities are distributed.",
]
encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
vectors = encoder.encode(documents, normalize_embeddings=True)
question = "What avoids recomputing earlier tokens?"
query = encoder.encode(question, normalize_embeddings=True)
source = documents[int(np.argmax(vectors @ query))]

generator = pipeline(
    "text-generation", model="HuggingFaceTB/SmolLM2-135M-Instruct")
prompt = f"Use this source to answer.\nSource: {source}\nQuestion: {question}"
result = generator([{"role": "user", "content": prompt}],
                   max_new_tokens=80, do_sample=False)
answer = result[0]["generated_text"][-1]["content"]
Kielimalli saa valitun lähdetekstin, ei hakuvektoria. Haun upotukset esittävät kokonaisia tekstikatkelmia. Ne ovat eri asia kuin tekstiä tuottavan mallin sisäiset tokenien upotukset.
Haku rajaa vastauksen mahdollisuudet
Vastaus riippuu siitä, mitä järjestelmä löytää ja miten malli aineistoa käyttää. Puuttuvat katkelmat, vanhentuneet dokumentit ja epäolennaiset osumat voivat pilata tuloksen. Lähteen antaminen ei takaa, että vastaus noudattaa sitä. Hyödyllinen järjestelmä säilyttää lähdetunnisteet, jotta lukija voi tarkistaa perustelut.
RAG muuttaa pyynnön aikana saatavilla olevaa tietoa. LoRA muuttaa mallin opittua toimintaa kouluttamalla. Menetelmiä voi käyttää yhdessä.