LoRA: kouluta suureen malliin pieni päivitys
LoRA (low-rank adaptation) hienosäätää mallia jäädyttämällä alkuperäiset painot ja opettamalla niiden rinnalle pienet lisämatriisit. Perusmalli säilyy, ja sovitin (adapter) tallentaa tehtävää tai tyyliä varten opitun muutoksen.
Tarkastellaan yhtä lineaarista kerrosta, jonka painomatriisi on W. Täysi hienosäätö voi muuttaa sen jokaista alkiota. LoRA esittää päivityksen kahden matriisin, A:n ja B:n, tulona. Niiden välissä on kapea ulottuvuus, aste (rank). Pienempi aste vähentää opetettavia parametreja ja rajoittaa päivityksen ilmaisukykyä.
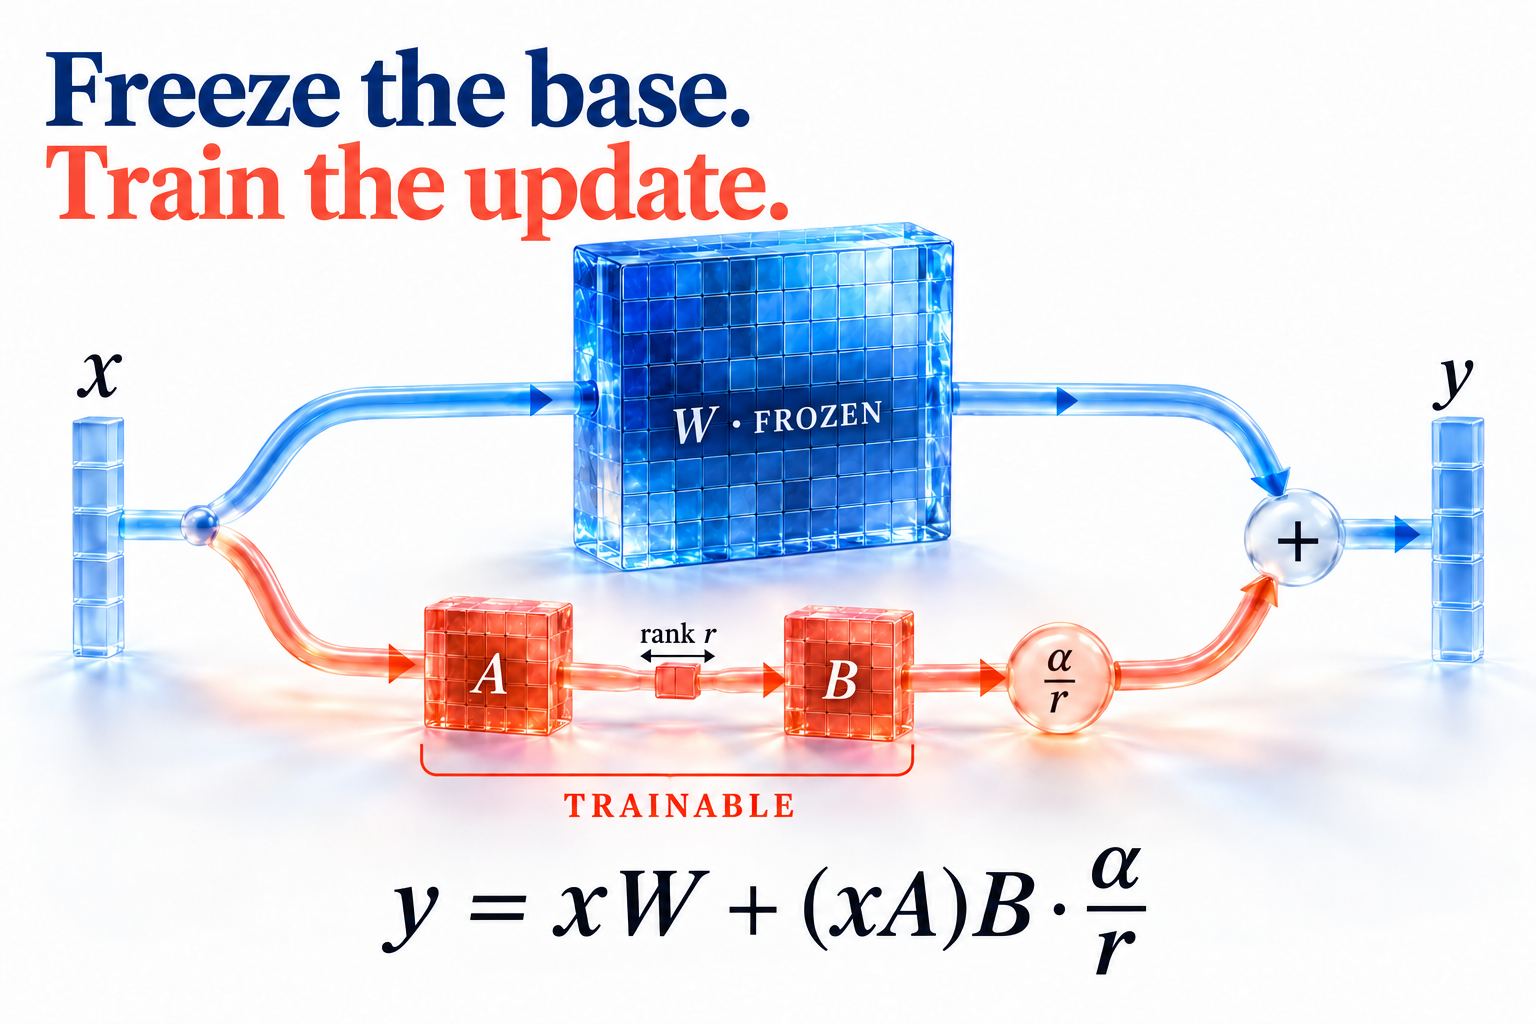
Laskenta eteenpäin
Kun syötteet ovat rivivektoreita, W:n muoto on input × output, A:n input × rank ja B:n rank × output. Tämä funktio ottaa matriisit vastaan ja yhdistää jäädytetyn kerroksen tulokseen opitun päivityksen. Sovittimen koulutus on erillinen vaihe.
import numpy as np

def lora_linear(x, weight, a, b, alpha):
    rank = a.shape[1]
    return x @ weight + (x @ a) @ b * (alpha / rank)
Neliömäisessä kerroksessa, jonka leveys on 4 096 ja aste 16, sovittimessa on 131 072 parametria. Perusmatriisissa niitä on 16,8 miljoonaa. Koulutuksessa optimointialgoritmin tila ja gradientit tarvitaan sovittimen parametreille jäädytettyjen peruspainojen sijaan. Aktivaatiot ja perusmalli vievät silti muistia.
Säilytä sovitin tai yhdistä painot
Haarat voidaan laskea erikseen, tai skaalattu tulo A @ B voidaan lisätä W:hen ennen mallin ajoa. Yhdistäminen poistaa valitun sovittimen ylimääräiset laskuoperaatiot. Erillisiä sovittimia on puolestaan helppo vaihtaa.
LoRA keventää hienosäätöä. Kvantisointi pienentää lukujen tallennustarkkuutta; QLoRA yhdistää kvantisoidun jäädytetyn perusmallin ja opetettavat sovittimet. Menetelmät vaikuttavat muistinkulutuksen eri osiin.