Upotukset: tunnisteista vektoreiksi
Upotus (embedding) esittää kohteen lukuarvoista koostuvana vektorina. Kielimallissa tokenin tunniste valitsee yhden rivin opitusta upotusmatriisista (embedding table). Tunniste toimii indeksinä; sen suuruus ei kuvaa tokenin merkitystä.
Matriisi oppii mallin mukana
Koulutuksessa gradientit päivittävät valittuja rivejä muiden malliparametrien ohella. Vektoreista tulee hyödyllisiä mallin oppiman ennustustehtävän ansiosta. Yksittäisillä koordinaateilla ei yleensä ole yksinkertaisia nimiä, kuten ”eläin” tai ”mennyt aikamuoto”. Tieto voi jakautua moniin koordinaatteihin.
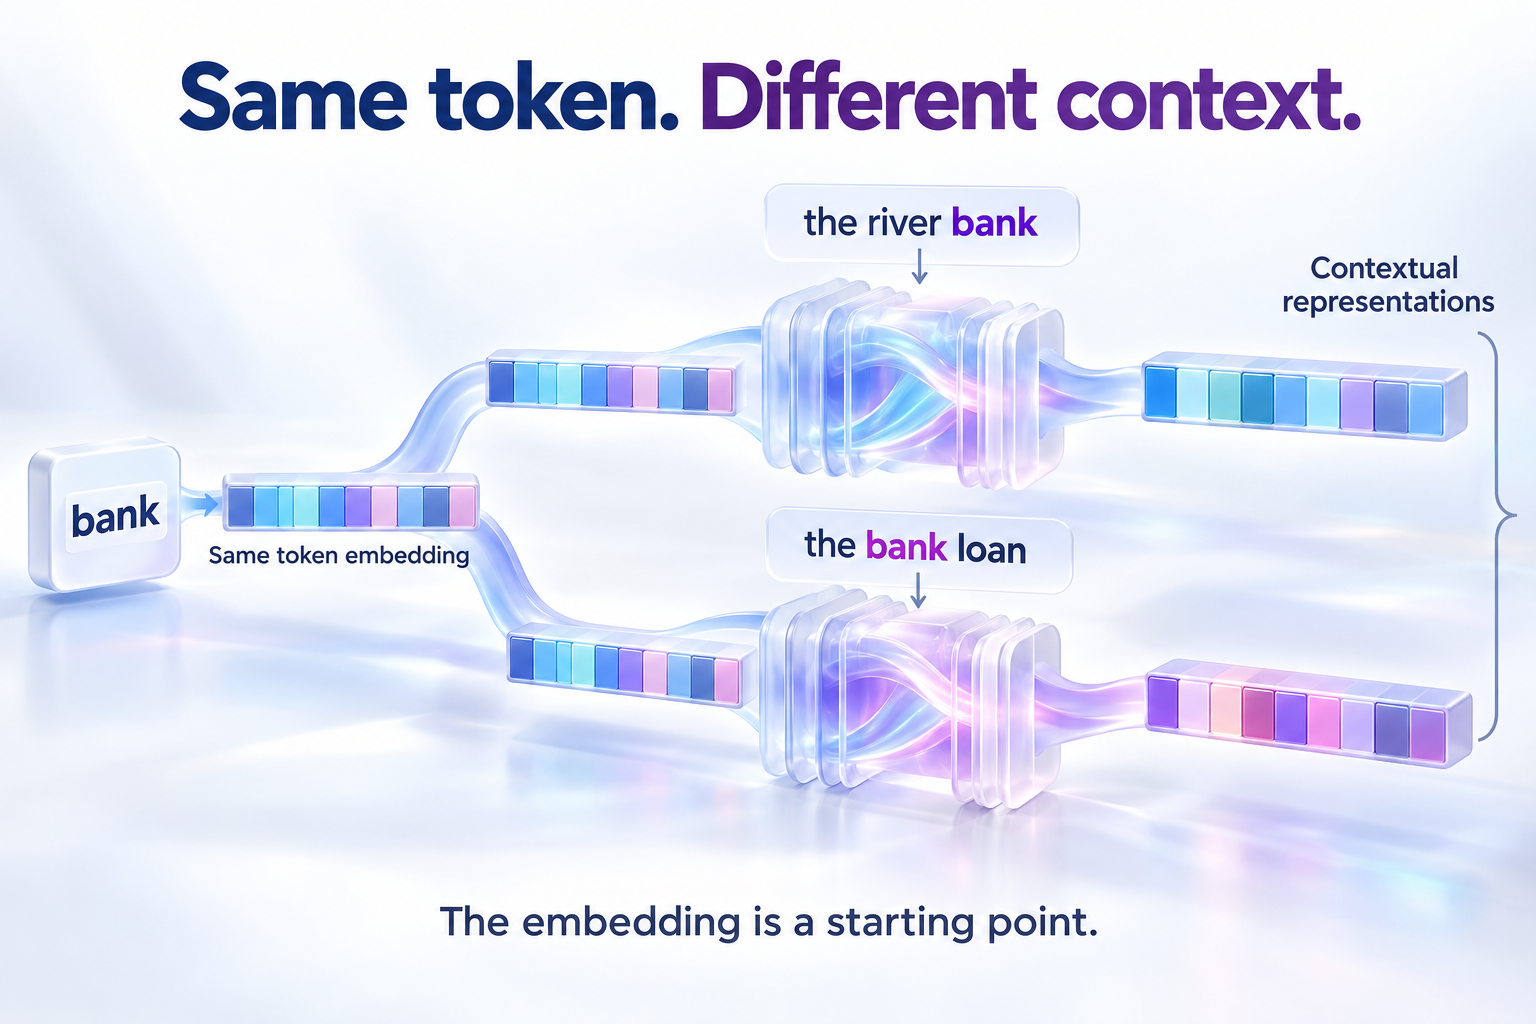
Tokeni saa aluksi saman matriisirivin jokaisessa esiintymässään. Myöhemmät kerrokset yhdistävät siihen sijaintia ja ympäröivää kontekstia. Sanan ”bank” esitys voi siksi kehittyä eri tavoin joenrantaa ja pankkia käsittelevissä englanninkielisissä lauseissa.
Syötä vektorit mallille
Kun torch ja transformers on asennettu, tämä esimerkki näyttää upotusten haun ja syöttää vektorit GPT-2:lle:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2")
inputs = tokenizer("The river bank", return_tensors="pt")

with torch.inference_mode():
    vectors = model.get_input_embeddings()(inputs.input_ids)
    scores = model(inputs_embeds=vectors).logits[0, -1]

next_id = scores.argmax().item()
continuation = tokenizer.decode([*inputs.input_ids[0].tolist(), next_id])
vectors sisältää eräulottuvuuden, yhden paikan kullekin syötetokenille ja koordinaatit upotuksen ulottuvuuksille. inputs_embeds antaa mallin jatkaa näistä vektoreista. GPT-2 lisää sijaintitiedon sisäisesti ennen kerrostensa laskentaa.
Tuloksena saatavat pisteet ennustavat edelleen seuraavaa tokenia. Upotus on numeerinen lähtöesitys, jolla tämä laskenta voidaan tehdä.
Tekstihakujärjestelmätkin käyttävät upotuksia, mutta muodostavat tavallisesti kokonaisten tekstijaksojen esitykset siihen tarkoitukseen koulutetulla mallilla. Tokenin upotusmatriisin rivi ei sellaisenaan välttämättä sovi dokumenttihakuun.
Aiheeseen liittyvät: tokenit, attention-mekanismi, vektoritietokanta.