Kvantisointi: vähemmän bittejä painoa kohti
Kvantisointi (quantization) esittää painot tai aktivaatiot pienemmällä joukolla mahdollisia arvoja. Jokaisen float32-painon säilyttämisen sijaan malli voi tallentaa pienen kokonaislukukoodin ja sen tulkitsemiseen tarvittavat tiedot.
Pienempi arvojoukko
Yksinkertainen menetelmä kuvaa painotensorin pienimmän arvon koodiksi 0 ja suurimman koodiksi 255. Väliin jäävät painot pyöristetään läheisiin koodeihin. Skaalauskerroin (scale) kertoo palautettujen vierekkäisten arvojen etäisyyden.
Kahdeksan bitin koodit vievät noin neljäsosan float32-painojen raakadatasta, minkä lisäksi tarvitaan metadataa. Neljän bitin koodeilla on 16 mahdollista arvoa. Vähäisempi tasomäärä tekee likiarvosta karkeamman. Poikkeavien painojen venyttämä arvoalue voi heikentää tavallisten painojen esitystarkkuutta. Painojen ryhmittely ja ryhmäkohtaiset skaalauskertoimet voivat parantaa tarkkuutta.
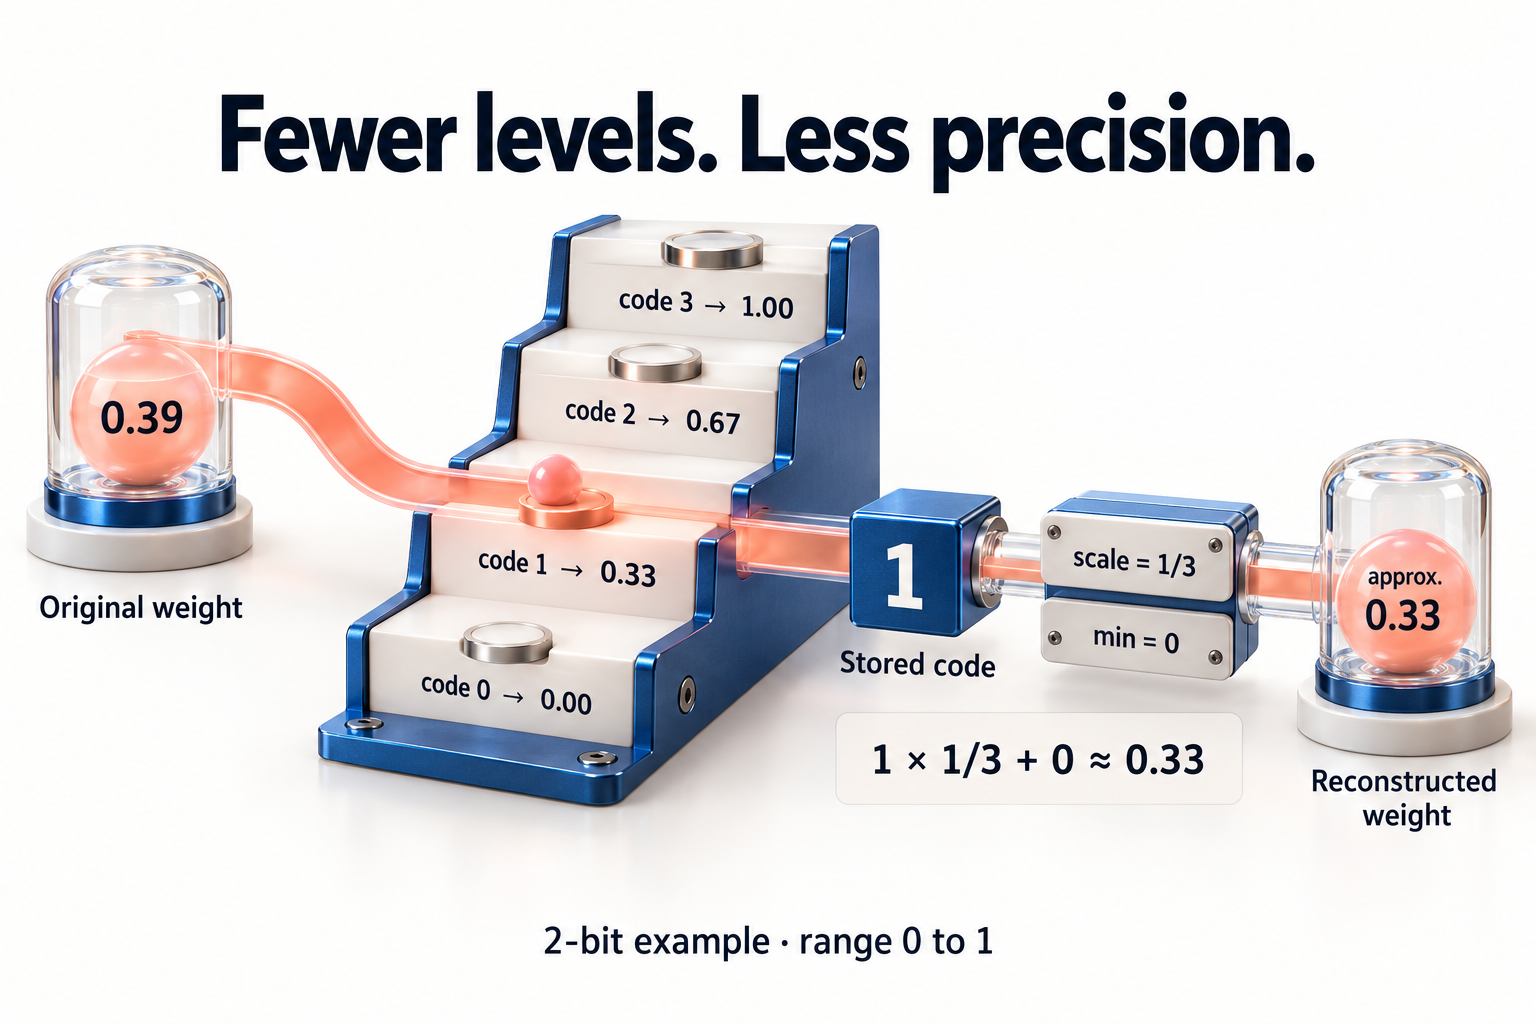
Kuva käyttää kahta bittiä, alla oleva koodi kahdeksaa.
Pakkaa ja palauta
Tämä NumPy-koodi noudattaa selainmallimme latauspainojen pakkausperiaatetta:
import numpy as np


def pack_weights(weights):
    minimum = float(weights.min())
    scale = float(weights.max() - minimum) / 255 or 1.0
    codes = np.clip(np.rint((weights - minimum) / scale), 0, 255)
    return codes.astype(np.uint8), minimum, scale


def unpack_weights(codes, minimum, scale):
    return codes.astype(np.float32) * scale + minimum
Anna mallin painotaulukko funktiolle pack_weights, tallenna palautetut koodit ja kaksi skalaaria ja muodosta float32-likiarvo funktiolla unpack_weights. Pyöristys hävittää tietoa, joten palautetut arvot eivät välttämättä vastaa alkuperäisiä täsmälleen.
Tallennus ja laskenta ovat eri valintoja
Ajonaikainen toteutus voi palauttaa liukulukupainot ennen laskentaa tai käyttää kvantisoitua dataa käsitteleviä laskentaytimiä (kernels). Ensimmäinen säästää lataustilaa mutta palauttaa muistiin alkuperäisen kokoiset liukulukupainot. Jälkimmäinen voi vähentää myös ajon muistinkäyttöä ja laskentaa, kun laitteisto ja toteutus tukevat sitä.
Kvantisoinnin huomioiva koulutus (quantization-aware training) ja kalibrointi (calibration) voivat auttaa säilyttämään mallin toimintakyvyn. Arvioi tulos oikeissa tehtävissä palautusvirheen lisäksi: pieni painotiedosto ei yksin osoita laadun säilymistä tai generoinnin nopeutumista.
Aiheeseen liittyvät: parametrit ja painot, KV-välimuisti, oma kvantisoitu selainmallimme.