KV-välimuisti: käytä tokenin taustatyö uudelleen
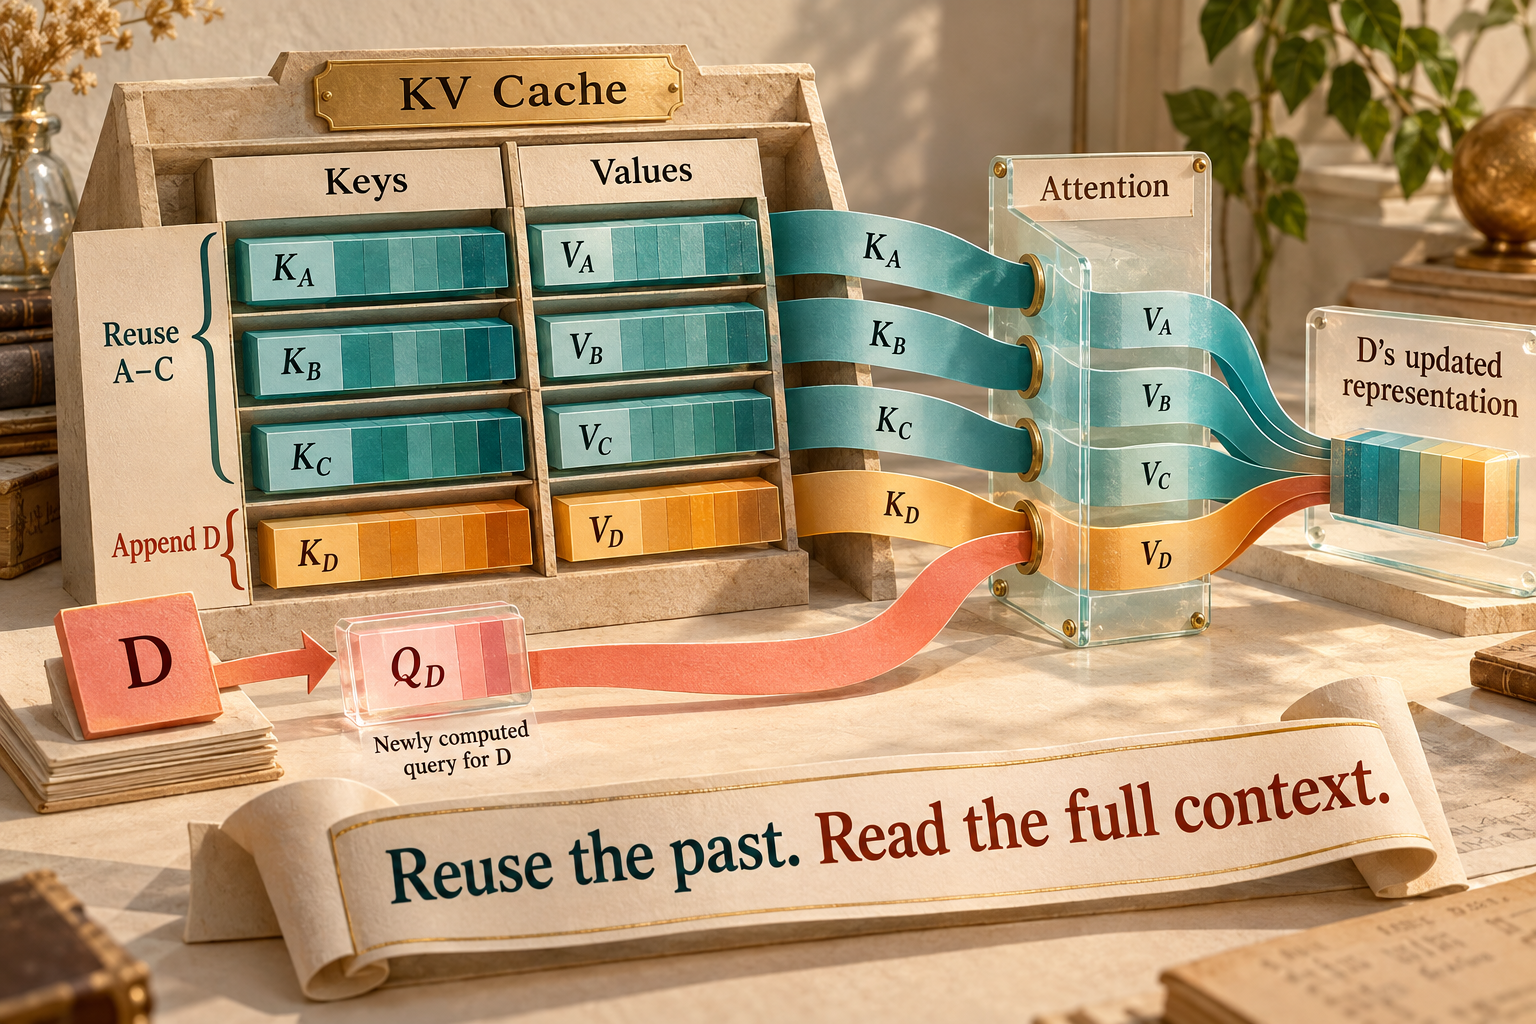
KV-välimuisti (KV cache) säilyttää aiemmille tokeneille lasketut avain- ja arvovektorit kussakin attention-kerroksessa. Seuraavan tokenin saapuessa malli voi käyttää näitä vektoreita käsittelemättä koko alkuosaa uudelleen.
Mikä säilyy ja mikä muuttuu
Kausaalisessa generoinnissa aiempi sijainti ei voi riippua myöhemmistä tokeneista. Sille jo lasketut avaimet ja arvot ovat siksi uudelleenkäytettävissä sekvenssin kasvaessa. Uusi tokeni tuottaa oman kyselynsä, avaimensa ja arvonsa. Kyselyä verrataan säilytettyihin avaimiin, ja tulos yhdistää niitä vastaavia arvoja.
Välimuisti säilyttää tekstijakson väliaikaista tilaa. Mallin opitut painot voidaan jakaa monien tekstijaksojen kesken, mutta kukin jakso voi tarvita oman välimuistinsa.
Jatka yhdellä uudella tokenilla
Kun torch ja transformers on asennettu, tämä esimerkki käsittelee kehotteen ja valitsee tokenin. Seuraavalle mallikutsulle annetaan vain uusi tokeni ja tallennettu välimuisti:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2")
inputs = tokenizer("The capital of France is", return_tensors="pt")

with torch.inference_mode():
    first = model(**inputs, use_cache=True)
    next_id = first.logits[:, -1].argmax(-1, keepdim=True)
    second = model(
        input_ids=next_id,
        past_key_values=first.past_key_values,
        use_cache=True,
    )
    following_id = second.logits[:, -1].argmax(-1).item()
Toinen kutsu saa yhden tokenin koko kehotteen sijaan. following_id ennustaa sitä seuraavan tokenin. Tässä esimerkissä ei ole täytemerkkejä; täytettyjen erien käsittelyssä tarvitaan myös vastaava koko kontekstin attention-maski.
Välimuisti säästää alkuosan toistuvalta käsittelyltä, mutta uusi kysely lukee edelleen aiempia avaimia ja arvoja. Tavallisessa täydessä attention-mekanismissa välimuistin koko kasvaa lineaarisesti säilytettyjen tokenien mukana, kun arkkitehtuuri ja tarkkuus pysyvät samoina. Rinnakkaiset tekstijaksot moninkertaistavat tarpeen.
Yhteisten alkuosien jakaminen ja välimuistilohkojen hallinta vähentävät päällekkäistä tallennusta. Tilan uudelleenkäyttö erillisten API-pyyntöjen välillä on samaan periaatteeseen perustuva palveluominaisuus. RAM-artikkelimme seuraa monen agentin kontekstien säilyttämistä.
Aiheeseen liittyvät: attention-mekanismi, syötteen käsittely eli prefill, kehotteen välimuistitus.