Autoregressiivinen generointi: valinta takaisin syötteeksi
Autoregressiivinen generointi (autoregressive generation) rakentaa jonon ennustamalla seuraavaa alkiota jo olemassa olevista. Kielimallissa alkiot ovat tokeneita. Kun yksi token on valittu, järjestelmä lisää sen jonoon ja pyytää mallilta seuraavaa ennustetta.
Malli tuottaa jakauman mahdollisista seuraavista tokeneista. Dekoodaussääntö ratkaisee valinnan. Suurimman pisteen valinta on ahne dekoodaus (greedy decoding); otanta tuo mukaan hallittua satunnaisuutta. Valittu token tulee kummassakin tapauksessa seuraavan askeleen syötteeksi.
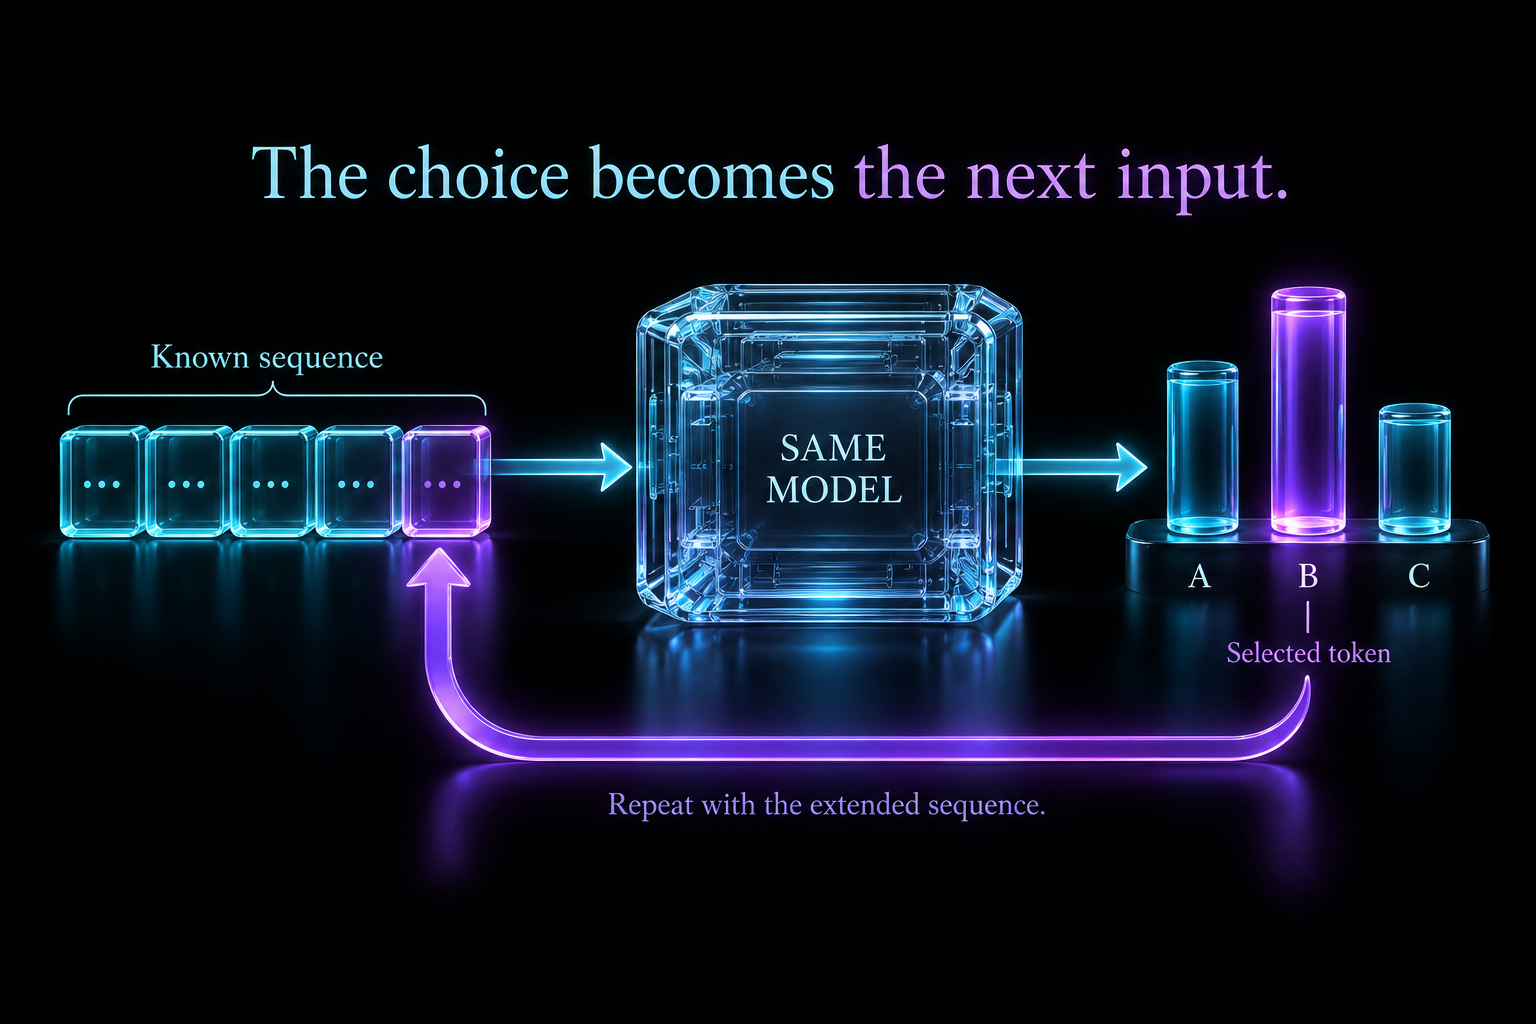
Tekstin jatkamisen silmukka
Tämä yhden jonon esimerkki käyttää PyTorchia ja Transformers-kirjastoa. Ensimmäinen laskentavaihe lukee koko kehotteen. Seuraavat vaiheet saavat vain uuden tokenin sekä kertyneen välimuistin. Mallin painot pysyvät samoina. Ensimmäinen ajo lataa GPT-2:n.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2").eval()
ids = tokenizer("Far far away", return_tensors="pt").input_ids
sequence, pending, cache = ids, ids, None

with torch.inference_mode():
    for _ in range(40):
        result = model(pending, past_key_values=cache, use_cache=True)
        pending = result.logits[:, -1].argmax(-1, keepdim=True)
        sequence = torch.cat([sequence, pending], dim=1)
        cache = result.past_key_values
        if pending.item() == tokenizer.eos_token_id:
            break

continuation = tokenizer.decode(sequence[0], skip_special_tokens=True)
Jonon päättävä token tai asetettu askelraja lopettaa silmukan. Ahne valinta tekee peräkkäisten valintojen riippuvuuden näkyväksi.
Rinnakkainen koulutus, peräkkäiset valinnat
Koulutuksessa tavoitejono on jo saatavilla. Kausaalinen maski sallii monen sijainnin ennusteiden laskemisen rinnakkain paljastamatta tulevia tokeneita. Tavallisessa generoinnissa tulevia valintoja ei vielä ole.
KV-välimuisti välttää aiempien avainten ja arvojen uudelleenlaskennan. Se ei poista seuraavan valinnan riippuvuutta edellisestä. Siksi pitkän vastauksen tuottaminen voi kestää, vaikka kehotteen käsittely olisi nopeaa.