Tokenit ja tokenisointi
Tokeni (token) on kielimallin syötteen tai tulosteen yksikkö. Tokenisoija (tokenizer) muuntaa tekstin numeeristen tokenitunnisteiden jonoksi. Kukin tunniste valitsee mallin upotusmatriisista (embedding table) yhden koulutuksessa opitun rivin. Rivi on upotusvektori (embedding), jota neuroverkko käsittelee.
Miksi tokeni ei ole sama kuin sana
Monet tokenisoijat säilyttävät yleiset sanat tai sanan osat kokonaisina ja jakavat harvinaisemman tekstin pienempiin osiin. Välilyönnit, välimerkit ja kirjoitusasu voivat vaikuttaa jakoon. Tokeni voi vastata kokonaista sanaa, sanan osaa tai jopa osaa merkin tavuesityksestä.
Byte-pair encoding eli BPE muodostaa sanaston yhdistämällä toistuvasti yleisiä vierekkäisiä yksiköitä. Näin teksti voidaan esittää tiiviisti, vaikka yksiköt eivät vastaisi sanojen tavurajoja tai merkityksiä. Mallin tokenisoija ja sanasto määräävät jaon, joten saman lauseen tokenimäärä voi vaihdella mallista toiseen.
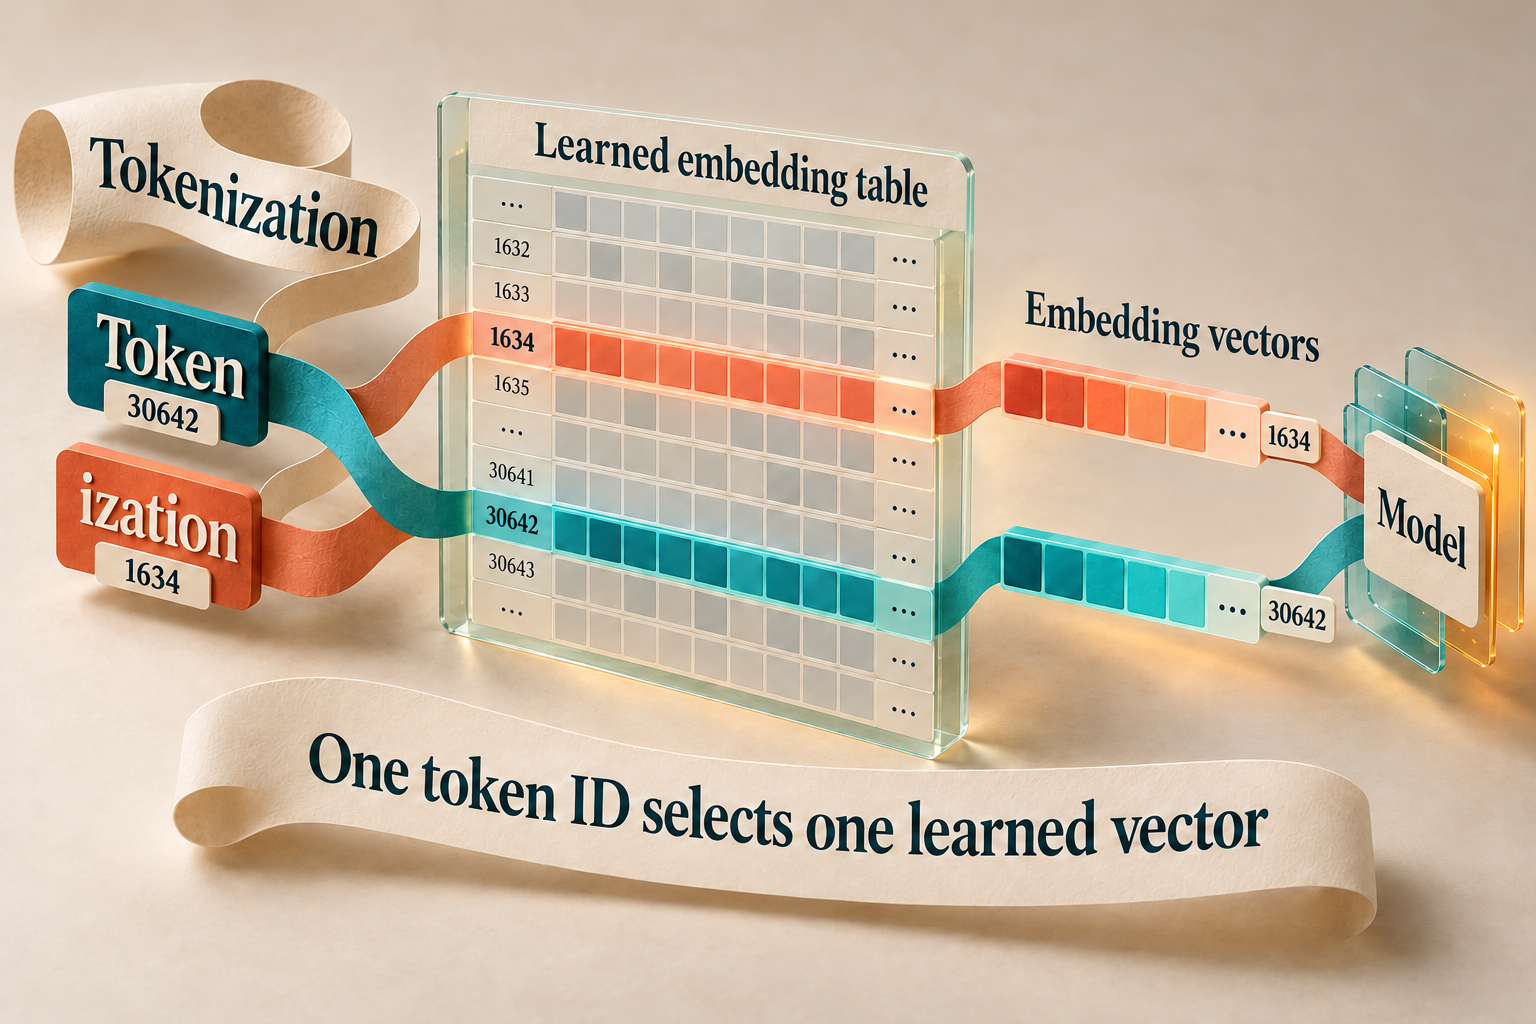
Tekstistä seuraavaan tokeniin
Kun torch ja transformers on asennettu, tämä esimerkki lataa GPT-2:n ja siihen sopivan tokenisoijan. Ensimmäisellä ajokerralla niiden tiedostot ladataan verkosta:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2")

inputs = tokenizer("The capital of France is", return_tensors="pt")

with torch.inference_mode():
    scores = model(**inputs).logits[0, -1]

next_id = scores.argmax().item()
continuation = tokenizer.decode([*inputs.input_ids[0].tolist(), next_id])
logits[0, -1] poimii erän ensimmäisen esimerkin viimeisen syötekohdan pisteet: yhden pisteytysarvon jokaiselle mahdolliselle seuraavalle tokenille. argmax() valitsee suurimman pistemäärän saaneen tokenin. Pidennetyn jonon dekoodaus tuottaa alkuperäisen tekstin ja valitun tokenin. Tämä on yksi tekstin tuottamisen vaihe.
Miksi tokenimäärällä on väliä
Malli ennustaa sanastonsa todennäköisyysjakauman ja valitsee seuraavan tokenin jokaisessa generointivaiheessa (generation). Pidempi tokenijono vie enemmän kontekstipaikkoja ja vaatii saman tekstin tuottamiseen enemmän vaiheita. Tokenimäärä vaikuttaa siksi kontekstirajoihin, vasteaikaan ja API-laskutukseen. Laske tokenit kohdemallin tokenisoijalla: sana- tai merkkimäärä ei vastaa tokenimäärää.
Aiheeseen liittyvät: konteksti-ikkuna, upotus, KV-välimuisti.