Vektoritietokannat: haku opitun esityksen perusteella
Vektoritietokanta (vector database) tallentaa vektoreita, tunnisteita ja niihin liittyvää tietoa sekä hakee kyselyvektorin lähellä olevia vektoreita. Semanttisessa haussa upotusmalli (embedding model) muuntaa tekstin tähän avaruuteen. Tietokanta hakee saamansa esityksen perusteella; upotusmalli määrää, mitä samankaltaisuus kuvaa.
Dokumentit ja kyselyt tarvitsevat yhteensopivat upotukset ja sopivan etäisyysmitan. Kosinisamankaltaisuus vertaa suuntia. Normalisoitujen vektorien pistetulo antaa saman järjestyksen kuin kosinisamankaltaisuus.
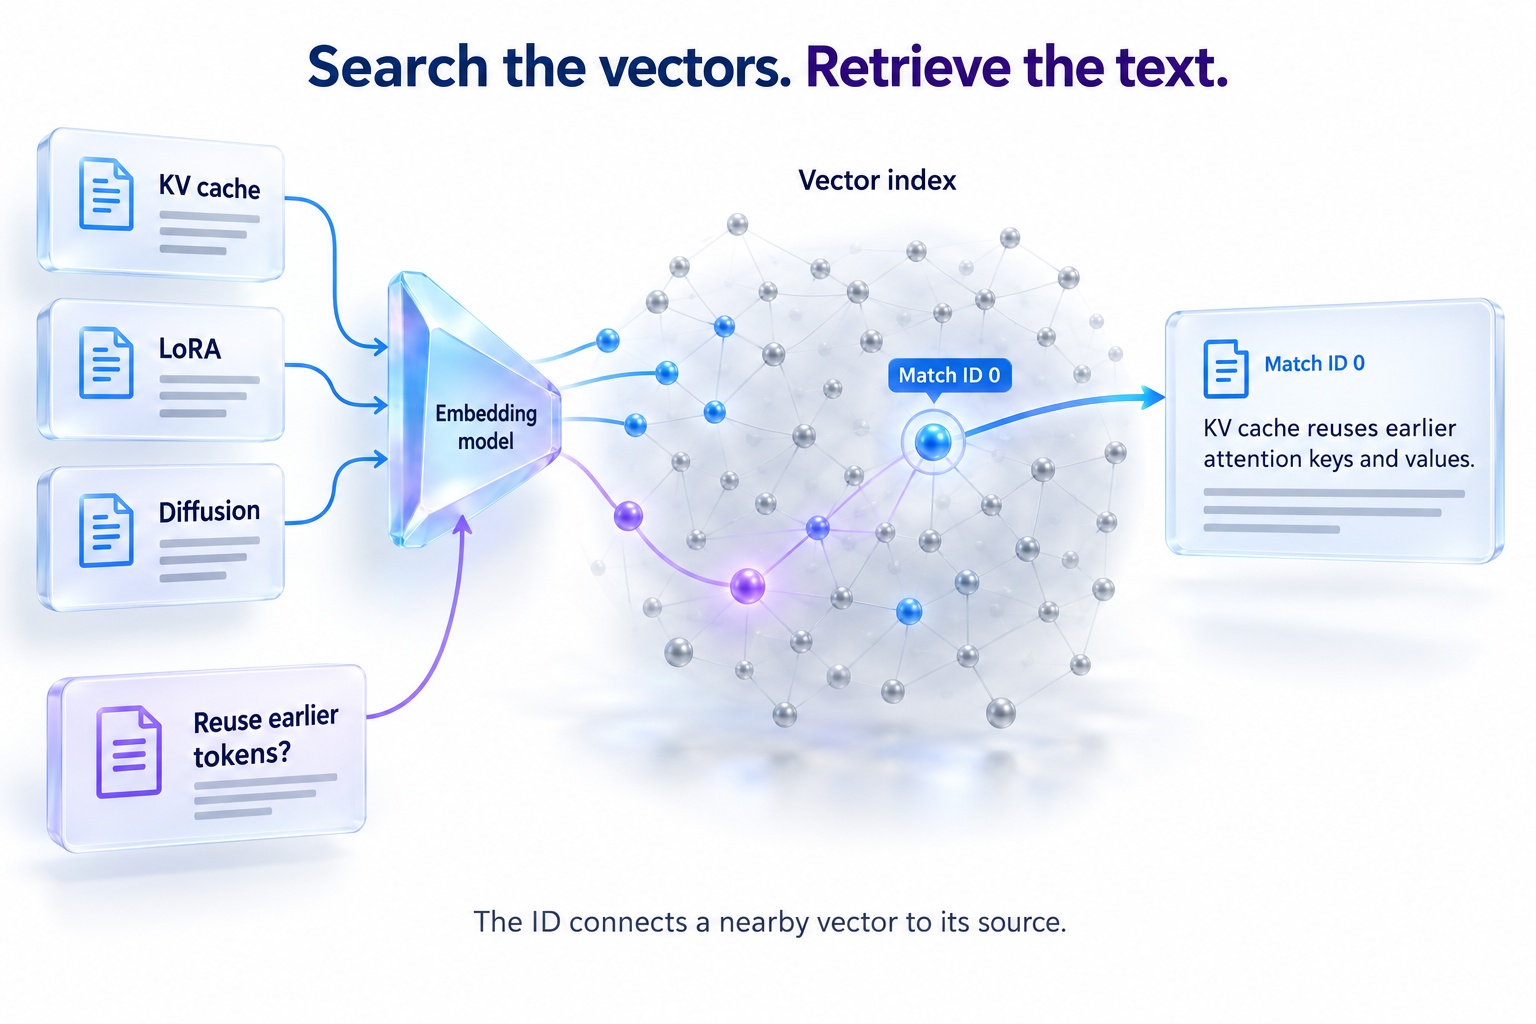
Haun ydin
Faiss on indeksointikirjasto eikä kokonainen tietokanta, mutta se tekee perusoperaation näkyväksi. Esimerkki muodostaa tekstien upotukset, lisää ne tarkkaan pistetuloindeksiin ja hakee sopivat katkelmat. Tarvitaan sentence-transformers ja faiss-cpu; enkooderin lataaminen lataa mallin painot.
import faiss
from sentence_transformers import SentenceTransformer

passages = [
    "KV cache reuses earlier attention keys and values.",
    "LoRA trains a small update to frozen model weights.",
    "Diffusion generation repeatedly updates a noisy sample.",
]
encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
vectors = encoder.encode(passages, normalize_embeddings=True).astype("float32")
index = faiss.IndexFlatIP(vectors.shape[1])
index.add(vectors)

query = encoder.encode(["How does a model avoid recomputing old tokens?"],
                       normalize_embeddings=True).astype("float32")
scores, rows = index.search(query, k=2)
retrieved = [passages[row] for row in rows[0]]
Rivitunnisteet yhdistävät vektoriosumat alkuperäisiin teksteihin. Tietokanta lisää tämän ympärille esimerkiksi pysyvän tallennuksen, metatietosuodatuksen ja päivitykset.
Nopea haku tekee kompromisseja
Tarkka suora indeksi vertaa kyselyä jokaiseen tallennettuun vektoriin. Likimääräinen lähinaapurihaku (approximate nearest-neighbour search) vähentää työtä tutkimalla valittuja avaruuden osia. Se tasapainottaa haun kattavuutta, muistia ja viivettä.
Läheinen vektori kertoo samankaltaisuudesta valitussa esityksessä, ei todista katkelman vastaavan kysymykseen oikein. Käyttöoikeuksiin tai aiheeseen perustuva suodatus ja ehdokkaiden uudelleenjärjestäminen voivat merkitä yhtä paljon kuin alkuperäinen etäisyyspiste.
RAG:ssa haettu teksti tulee mallin kontekstiksi. Vektoritietokanta löytää ehdokkaat; kielimallin täytyy edelleen käyttää niiden sisältöä.