Transformer: tietoa tokenien välillä ja niiden sisällä
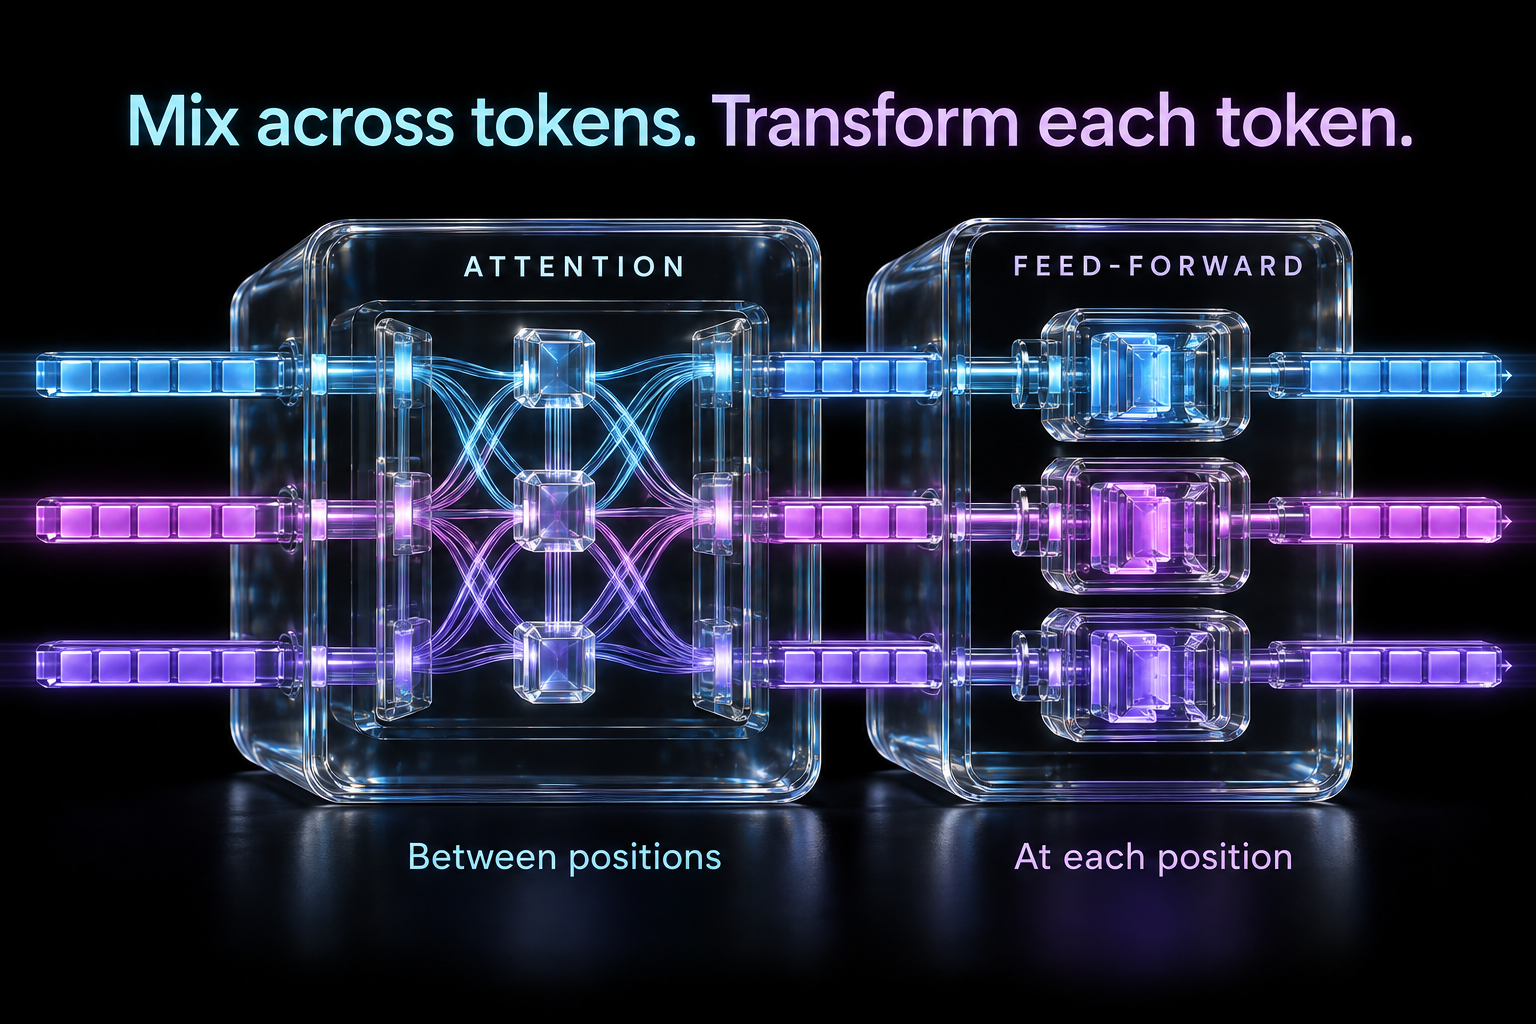
Transformer käsittelee jonoa vektoreina. Sen toistuva lohko yhdistää kaksi operaatiota: attention-mekanismi yhdistää tietoa tokenien eri sijainneista, ja eteenpäinkytketty verkko (feed-forward network) muuntaa kunkin sijainnin vektoria. Peräkkäisissä lohkoissa esitykset saavat yhä enemmän tietoa kontekstista.
Eteenpäinkytketyn verkon painot ovat yhteiset kaikille sijainneille, mutta jokainen sijainti tuo verkolle oman syötevektorinsa. Jäännösyhteydet (residual connections) lisäävät operaation tuloksen sen syötteeseen. Normalisointi säätelee esitysten mittakaavaa.
Lohko, jonka toimintaa voi tutkia
Tämä Keras-lohko normalisoi syötteen ennen kumpaakin operaatiota. Kausaalinen maski estää sijaintia käyttämästä myöhempiä sijainteja. Tätä tarvitaan, kun malli opetetaan ennustamaan seuraavaa tokenia. Syötteen muoto on batch × tokens × width; valitse leveys, joka on jaollinen attention-päiden määrällä.
import tensorflow as tf

class TransformerBlock(tf.keras.layers.Layer):
    def __init__(self, width, heads):
        super().__init__()
        self.norm1 = tf.keras.layers.LayerNormalization()
        self.attention = tf.keras.layers.MultiHeadAttention(
            num_heads=heads, key_dim=width // heads)
        self.norm2 = tf.keras.layers.LayerNormalization()
        self.ffn = tf.keras.Sequential([
            tf.keras.layers.Dense(4 * width, activation="gelu"),
            tf.keras.layers.Dense(width),
        ])

    def call(self, x, training=False):
        normalized = self.norm1(x)
        x = x + self.attention(
            normalized, normalized, use_causal_mask=True,
            training=training)
        return x + self.ffn(self.norm2(x), training=training)
Kokonainen kielimalli tarvitsee lisäksi tokenien upotukset, sijaintitiedon ja projektion sanaston tokenien pisteiksi. Sijaintitieto voi tulla upotuksista tai itse attention-laskennasta. Lohko on mallin toistuva laskennallinen ydin.
Pelkästä dekooderista koostuva malli käyttää kausaalista attention-mekanismia tekstin jatkamiseen. Enkooderissa attention toimii yleensä molempiin suuntiin; enkooderi–dekooderimalli yhdistää nämä rakenteet. Small Language Model -artikkelissamme rakennetaan näistä osista toimiva dekooderi, jota voi ajaa selaimessa.