Spekulatiivinen dekoodaus: ehdota etukäteen, tarkista yhdessä
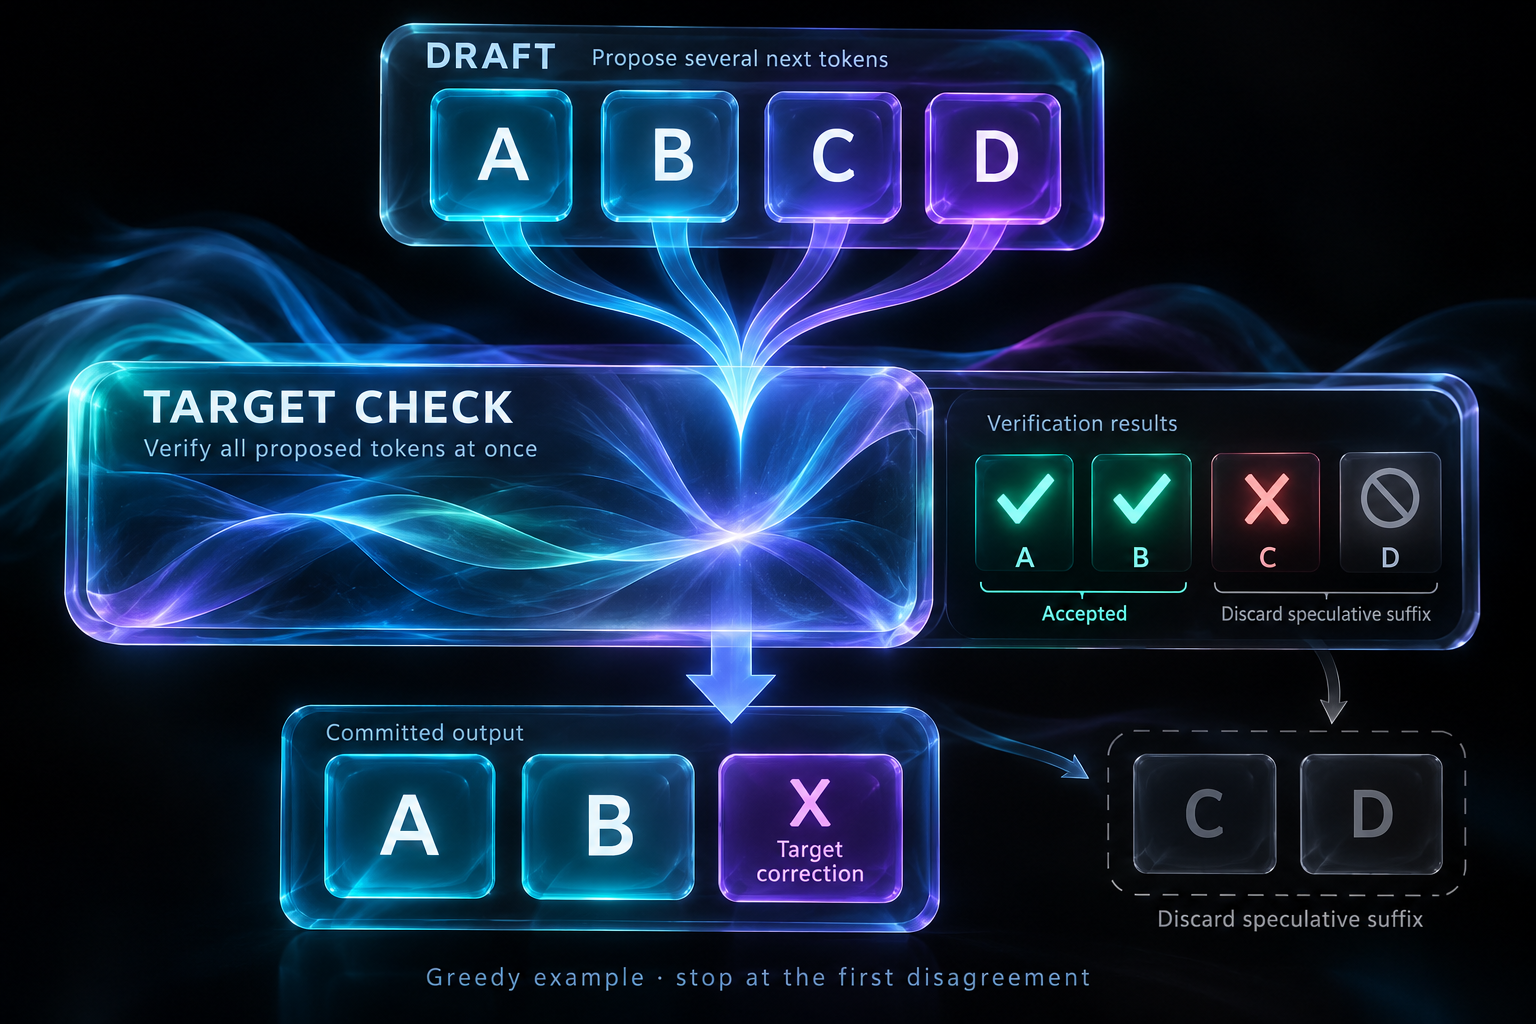
Spekulatiivinen dekoodaus (speculative decoding) nopeuttaa autoregressiivistä generointia erottamalla tokenien ehdottamisen niiden tarkistamisesta. Kevyt luonnostelumenetelmä ehdottaa useita tokeneita. Kohdemalli arvioi ehdotetun jatkon leveämmässä laskentavaiheessa, jolloin monta hyväksyttyä tokenia voi viedä vastausta eteenpäin kerralla.
Kohdemalli määrää silti hyväksyttävän jatkon. Ahneessa versiossa tokenit voidaan säilyttää niin pitkälle kuin ne vastaavat kohdemallin valintoja. Ensimmäisessä erossa otetaan kohdemallin korjaus ja hylätään ehdotuksen loppuosa. Otantaa käyttävät versiot säilyttävät kohdemallin jakauman hyväksymissäännön ja korjatun otantajakauman avulla.
Kokeile apumallia
Transformers tarjoaa tähän argumentin assistant_model. Tämä PyTorch-esimerkki käyttää pienempää GPT-2-perheen luonnostelijaa ja kohdemallin tokenisoijaa. Ensimmäinen ajo lataa molemmat mallit.
from transformers import AutoModelForCausalLM, AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2").eval()
draft = AutoModelForCausalLM.from_pretrained("distilgpt2").eval()
inputs = tokenizer("Far far away", return_tensors="pt")

output = model.generate(
    **inputs, assistant_model=draft, max_new_tokens=40,
    do_sample=False, pad_token_id=tokenizer.eos_token_id)
continuation = tokenizer.decode(output[0], skip_special_tokens=True)
Kirjasto hoitaa luonnostelun, tarkistuksen ja välimuistin ylläpidon. Olennainen operaatio on monen ehdotetun sijainnin tarkistaminen yhdessä sen sijaan, että jokainen token vaatisi oman raskaan kohdemallikutsunsa.
Milloin ennakointi kannattaa
Nopeus riippuu ehdotusten hyväksymisasteesta sekä niiden tuottamisen ja tarkistamisen hinnasta. Huono luonnostelija laskee tokeneita, jotka heitetään pois. Kuormitetun palvelimen suuret erät voivat muuttaa tasapainoa verrattuna yhteen vuorovaikutteiseen pyyntöön.
Häviötön spekulatiivinen otanta säilyttää jakauman, ei välttämättä samaa satunnaista jonoa samalla siemenluvulla. Nopeutus syntyy ajoituksesta ja rinnakkaisesta tarkistamisesta. Se täydentää KV-välimuistia, joka käyttää aiempaa attention-tilaa uudelleen.