MoE: paljon painoja, vain osa käytössä
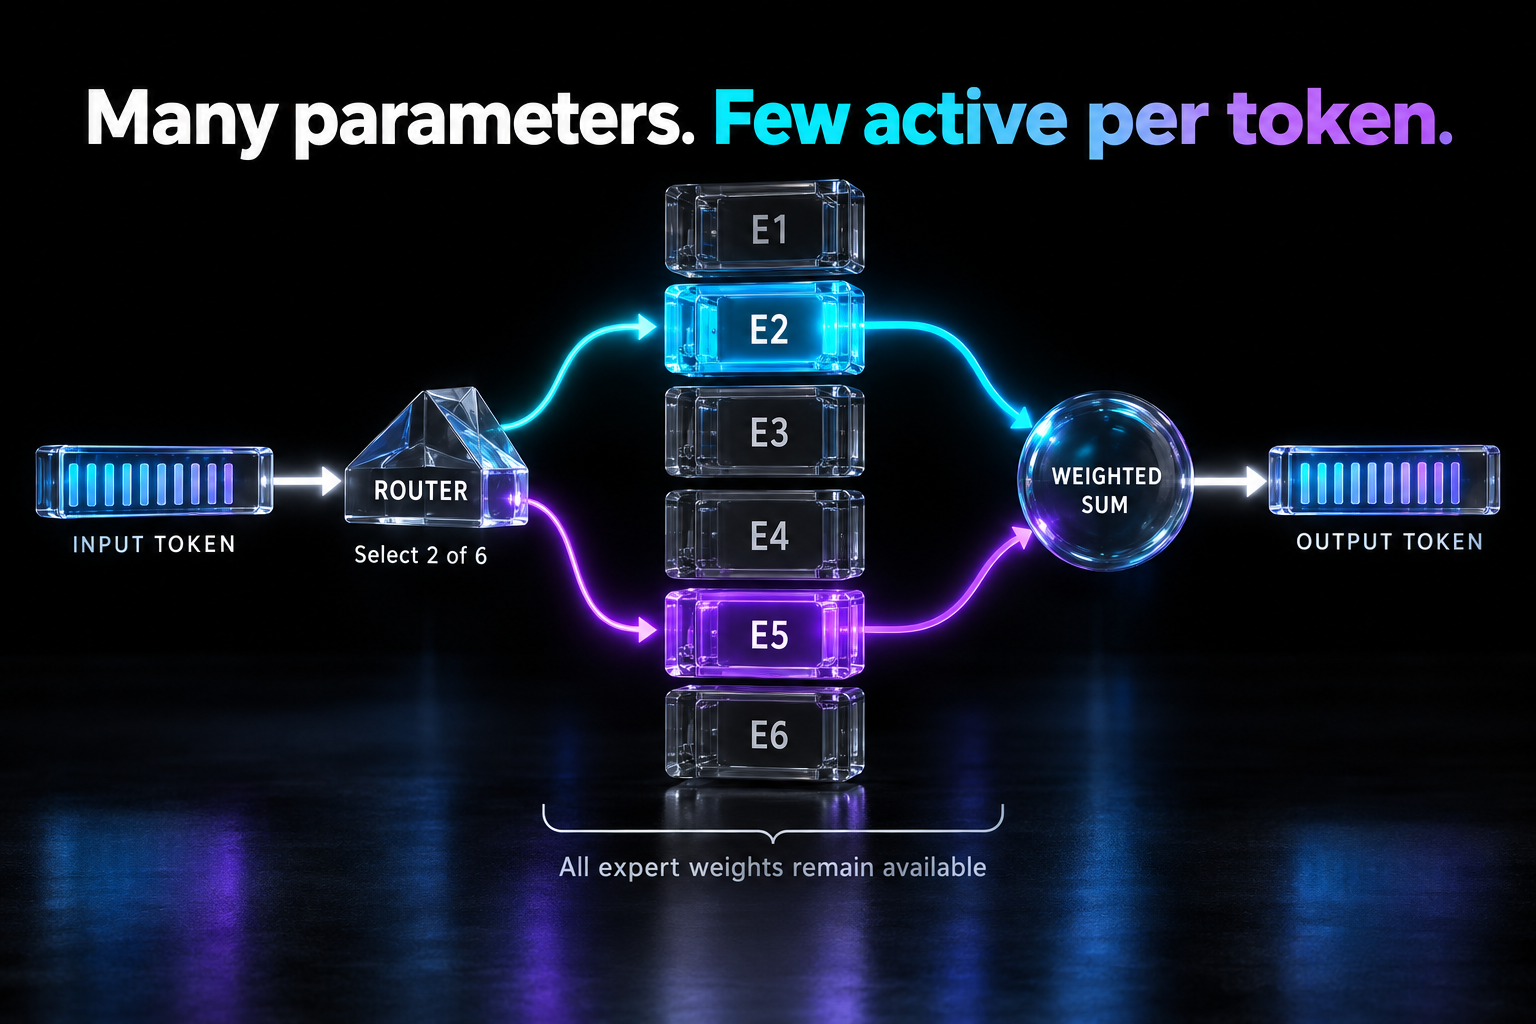
Asiantuntijamalli (mixture of experts, MoE) ohjaa laskentaa valituille neuroverkoille, joita kutsutaan asiantuntijoiksi (experts). Harvasti aktivoituvassa Transformer-mallin MoE-kerroksessa opittu reititin (router) valitsee kullekin tokenille pienen määrän eteenpäinkytkettyjä asiantuntijaverkkoja. Attention-mekanismi ja muut mallin osat voivat olla yhteisiä.
Näin parametrien kokonaismäärä ja aktiivisten parametrien määrä eroavat toisistaan. Mallissa voi olla monta asiantuntijaa, vaikka yhden tokenin käsittelyssä käytetään vain muutamaa. Seuraava token voi kulkea eri reittiä. Asiantuntija on opittu laskentaoperaatio; nimi ei takaa ihmiselle tunnistettavaa erikoisalaa, kuten matematiikkaa tai historiaa.
Valitse, laske ja yhdistä
Tämä NumPy-funktio reitittää yhden tokenin kahdelle asiantuntijalle. router muuntaa syötevektorin pisteiksi, joita on yksi kutakin asiantuntijaa kohti. Vain valitut asiantuntijafunktiot suoritetaan. Niiden tulokset yhdistetään painoilla, jotka normalisoidaan valitun joukon sisällä. Jokainen asiantuntija palauttaa samanmuotoisen vektorin.
import numpy as np

def moe_token(x, router, experts, k=2):
    scores = x @ router
    selected = np.argpartition(scores, -k)[-k:]
    weights = np.exp(scores[selected] - scores[selected].max())
    weights /= weights.sum()
    return sum(weight * experts[index](x)
               for weight, index in zip(weights, selected))
Todelliset toteutukset käsittelevät tokenieriä ja siirtävät ne laitteille, joilla valitut asiantuntijat sijaitsevat. Reitityskaavat vaihtelevat; tämä esimerkki näyttää valinnan ja painotetun yhdistämisen.
Harva laskenta tarvitsee silti muistia
Passiiviset asiantuntijat eivät laske tämän tokenin tulosta, mutta niiden painojen täytyy olla saatavilla muille tokeneille. Parametrien kokonaismäärä vaikuttaa siksi tallennustilaan ja mallin ajon muistitarpeeseen, vaikka aktiivinen laskenta olisi paljon pienempi.
Reititys vaikuttaa myös laitteiston käyttöön. Jos moni token valitsee saman asiantuntijan, sen laitteesta voi tulla pullonkaula. Koulutuksessa ohjataan käyttöä tasaisemmaksi, ja hajautettu järjestelmä siirtää tokenien esityksiä laitteiden välillä. Asiantuntijoiden lisääminen ei siis tuo malliin kapasiteettia ilmaiseksi.
MoE valitsee käytettävät eteenpäinkytketyt verkot. Attention-mekanismi välittää tietoa tokenien sijaintien välillä. Ne täydentävät toisiaan Transformerissa.