Vastavirta-algoritmi: mitkä painot muuttivat häviötä
Vastavirta-algoritmi (backpropagation) laskee, miten häviö muuttuu sen tuottaneiden parametrien mukana. Se kulkee laskentaa taaksepäin ja soveltaa ketjusääntöä jokaisessa operaatiossa. Tuloksena on gradientti jokaiselle laskentaan osallistuneelle opetettavalle parametrille.
Optimointialgoritmi käyttää gradientteja painojen päivittämiseen. Vastavirta-algoritmi laskee muutoksen suunnan; optimointialgoritmi päättää, miten askel otetaan. Nämä ovat eri operaatioita.
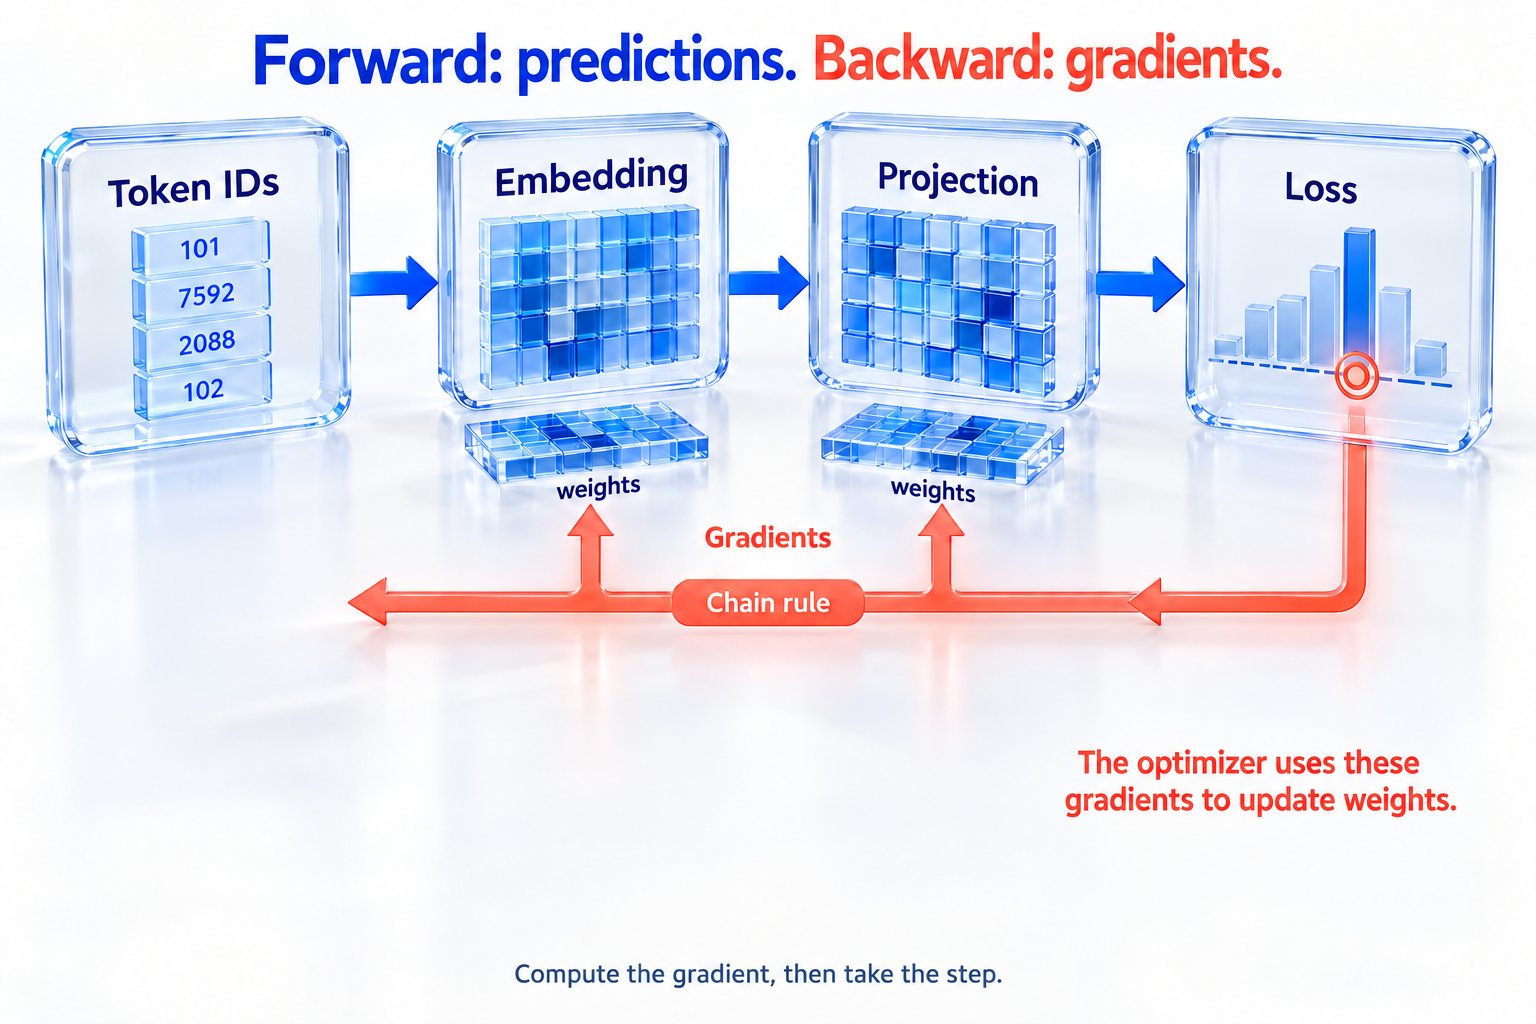
Pieni seuraavan tokenin verkko sisältä nähtynä
Tässä NumPy-esimerkissä tokenin upotusta seuraa projektio sanastoon. Mallissa ei ole attention-mekanismia eikä kontekstin yhdistämistä: kukin syötetoken ennustaa yhtä seuraavaa tokenia. tokens ja targets ovat yhtä pitkiä tunnistetaulukoita. embedding on muotoa vocabulary × width ja output muotoa width × vocabulary.
Laskenta eteenpäin tuottaa pisteet ja todennäköisyydet. Laskenta taaksepäin derivoi keskimääräisen ristientropian (cross-entropy) ja kuljettaa gradientit projektion kautta valittuihin upotusriveihin. Molempia painotaulukoita päivitetään suoraan.
import numpy as np

def train_step(tokens, targets, embedding, output, rate):
    hidden = embedding[tokens]
    logits = hidden @ output
    probabilities = np.exp(logits - logits.max(axis=1, keepdims=True))
    probabilities /= probabilities.sum(axis=1, keepdims=True)

    grad_scores = probabilities.copy()
    grad_scores[np.arange(len(tokens)), targets] -= 1
    grad_scores /= len(tokens)
    grad_output = hidden.T @ grad_scores
    grad_hidden = grad_scores @ output.T

    np.add.at(embedding, tokens, -rate * grad_hidden)
    output -= rate * grad_output
np.add.at on tarpeen, kun sama token esiintyy monta kertaa: yhteiselle upotusriville tulevat vaikutukset täytyy laskea yhteen.
Sama periaate suuremmassa mittakaavassa
Automaattisen derivoinnin kirjastot tallentavat operaatiot ja hoitavat ketjusäännön laskennan. Transformerissa operaatioita on paljon enemmän, mutta koulutuksessa häviön gradientti kulkee edelleen niiden läpi taaksepäin.
Välivaiheiden aktivaatiot tarvitaan derivaattojen laskemiseen. Niiden säilyttäminen tai uudelleenlaskenta on yksi syy siihen, miksi koulutuksen muistitarve eroaa pelkästä mallin ajosta.