RLHF: opi koulutussignaali ihmisten mieltymyksistä
Ihmispalautteeseen perustuva vahvistusoppiminen (reinforcement learning from human feedback, RLHF) käyttää ihmisten arvioita mallin toiminnan kouluttamiseen. Jokaiselle vastaukselle ei tarvitse kirjoittaa palkkiosääntöä: ihmiset voivat verrata tuotoksia ja kertoa, kumpaa suosivat.
Tavallisessa kielimalliputkessa ohjatut esimerkit opettavat ensin hyödyllisiä vastauksia. Sen jälkeen ihmiset järjestävät saman kehotteen vaihtoehtoisia vastauksia paremmuusjärjestykseen. Palkkiomalli (reward model) oppii ennustamaan näitä mieltymyksiä, ja vahvistusoppiminen päivittää kielimallia opitun signaalin avulla.
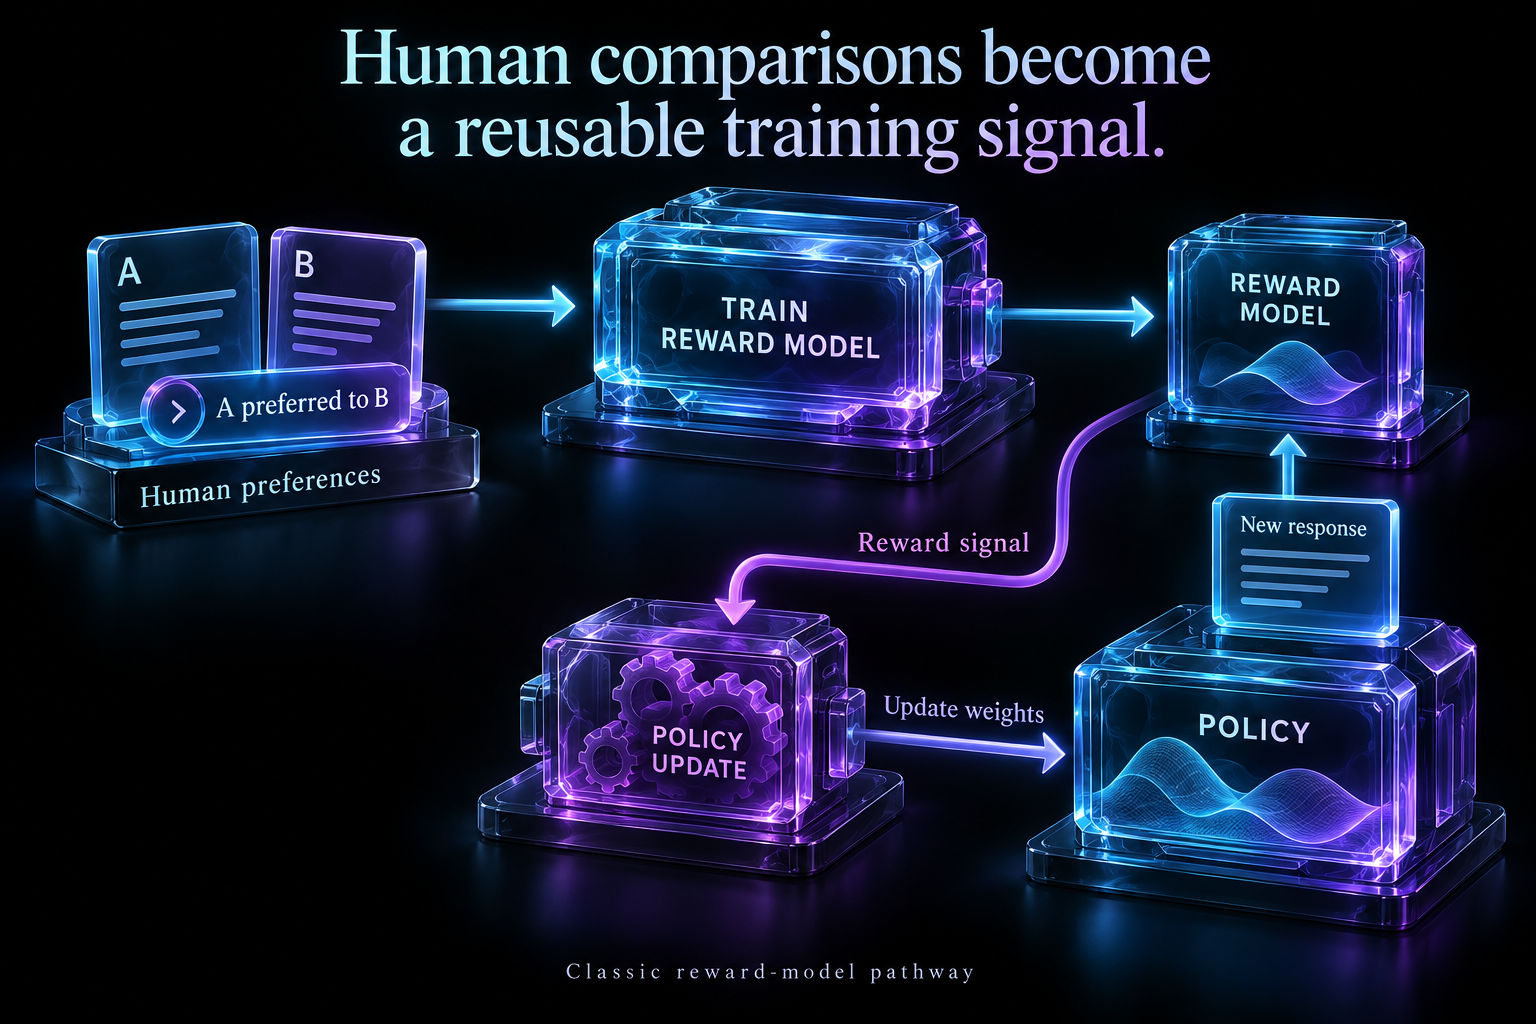
Ihminen ei pisteytä jokaista päivitystä
Koulutettu palkkiomalli voi pisteyttää uusia tuotoksia. Näin palautetta voidaan hyödyntää monissa toimintamallin päivityksissä. Päivitettävää kielimallia kutsutaan usein toimintapolitiikaksi (policy): se valitsee tokeneita, ja palkkiosignaali ohjaa valintojen muuttumista koulutuksessa.
Rajoite tai rangaistus voi estää toimintapolitiikkaa ajautumasta liian kauas vertailumallista. Tämä auttaa säilyttämään hyödyllistä toimintaa uuden tavoitteen optimoinnin aikana.
Mitä palkkio oikeastaan kuvaa
Mieltymys on arvio tietyssä tehtävässä, tietyillä kriteereillä ja tietyiltä arvioijilta. Palkkiomalli jäljittelee näitä arvioita. Sen pisteiden optimointi ei automaattisesti optimoi totuutta tai jokaisen käyttäjän tavoitteita. Koulutussignaalia täytyy arvioida haluttua toimintaa vasten.
Muut mieltymyksiin perustuvat menetelmät, kuten suora preferenssioptimointi (direct preference optimization, DPO), oppivat suosituista ja hylätyistä vastauksista ilman samanlaista erillisen palkkiomallin ja vahvistusoppimisen silmukkaa.
RLHF on koulutusprosessi. Se eroaa agentin työkalutuloksen lukemisesta tehtävän aikana: tavallinen agentin ajo voi muuttaa seuraavaa toimintoa mallin painojen pysyessä samoina.