Perpleksisyys: kuinka yllättävä oikea jatko oli?
Perpleksisyys (perplexity) mittaa, miten hyvin kielimalli ennustaa havaittuja tokeneita. Jokaisen todellisen seuraavan tokenin todennäköisyydestä otetaan negatiivinen logaritmi, arvot keskiarvoistetaan ja tuloksesta otetaan eksponentti. Pienempi perpleksisyys tarkoittaa suurempaa todennäköisyyttä havaitulle jatkolle kyseisessä arviointiasetelmassa.
Jos malli antaa jokaiselle havaitulle seuraavalle tokenille todennäköisyyden yksi neljäsosa, perpleksisyys on neljä. Tasainen jakauma tuhannen tokenin sanastossa antaa perpleksisyydeksi tuhat. Esimerkit selittävät asteikkoa; todellisten jakaumien ei tarvitse olla tasaisia.
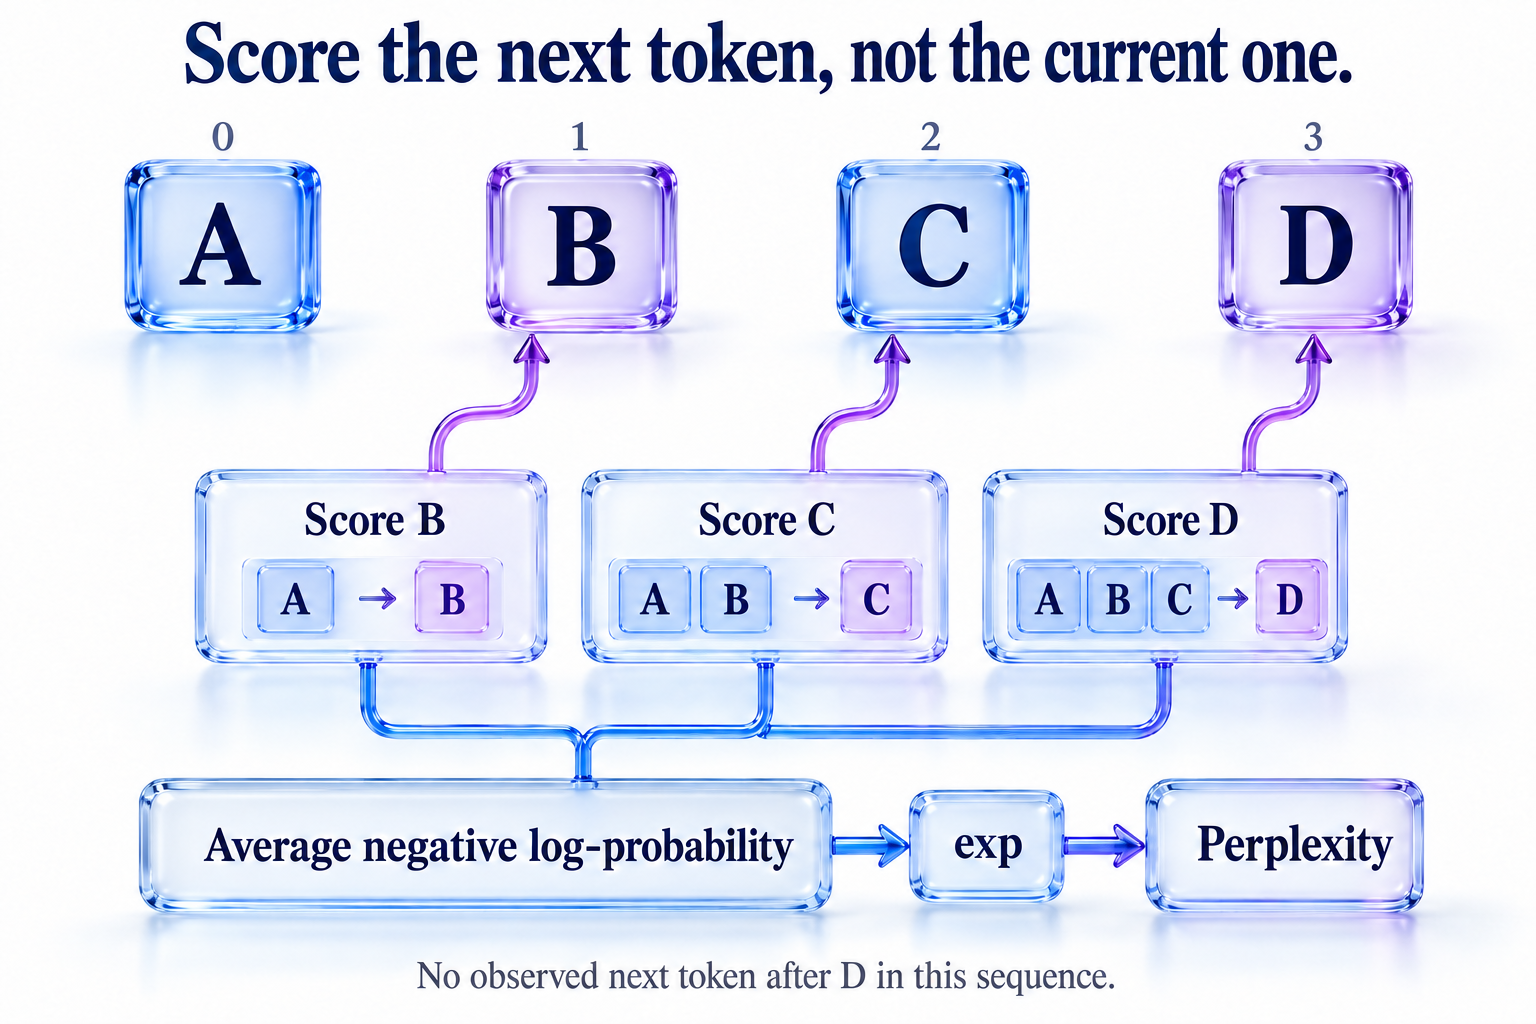
Pisteytä seuraava sijainti
Tämä NumPy-funktio ottaa kausaalisen mallin logitit muodossa tokens × vocabulary ja saman täyttämättömän jonon tokenitunnisteet. Jonossa täytyy olla vähintään kaksi tokenia. Sijainti nolla ennustaa tokenia yksi, joten taulukoita siirretään ennen pisteytystä. Viimeiselle logittiriville ei ole tässä havaittua seuraavaa tokenia, joten se jätetään pois.
import numpy as np

def perplexity(logits, token_ids):
    scores = logits[:-1]
    targets = token_ids[1:]
    shifted = scores - scores.max(axis=1, keepdims=True)
    log_normalizer = np.log(np.exp(shifted).sum(axis=1))
    losses = log_normalizer - shifted[np.arange(len(targets)), targets]
    return float(np.exp(losses.mean()))
Vakaa logaritminen normalisointi välttää hyvin pienten todennäköisyyksien muodostamisen. Tämä on pisteytyslaskenta: se ei arvo jatkoa eikä päivitä painoja.
Vertaa vertailukelpoisia tuloksia
Tokenisointi muuttaa ennustettavaa asiaa ja keskiarvoon laskettavien ennusteiden määrää. Myös aineisto ja jokaisen ennusteen käytettävissä oleva konteksti muuttavat tulosta. Mallien vertailu vaatii yhteensopivan tokenisoinnin ja arviointiolosuhteet tai yhteiseen yksikköön normalisoidun mittarin.
Kun teksti ylittää konteksti-ikkunan, päällekkäiset arviointi-ikkunat voivat antaa ennusteille enemmän edeltävää tekstiä kuin erilliset lohkot. Tämä voi muuttaa raportoitua tulosta olennaisesti.
Perpleksisyys mittaa valitun tekstin ennustamista. Se ei suoraan arvioi ohjeiden noudattamista, tosiasiallista oikeellisuutta eikä vastauksen hyötyä ihmiselle.